QI des intelligences artificielles :
ce que mesure vraiment ce classement.
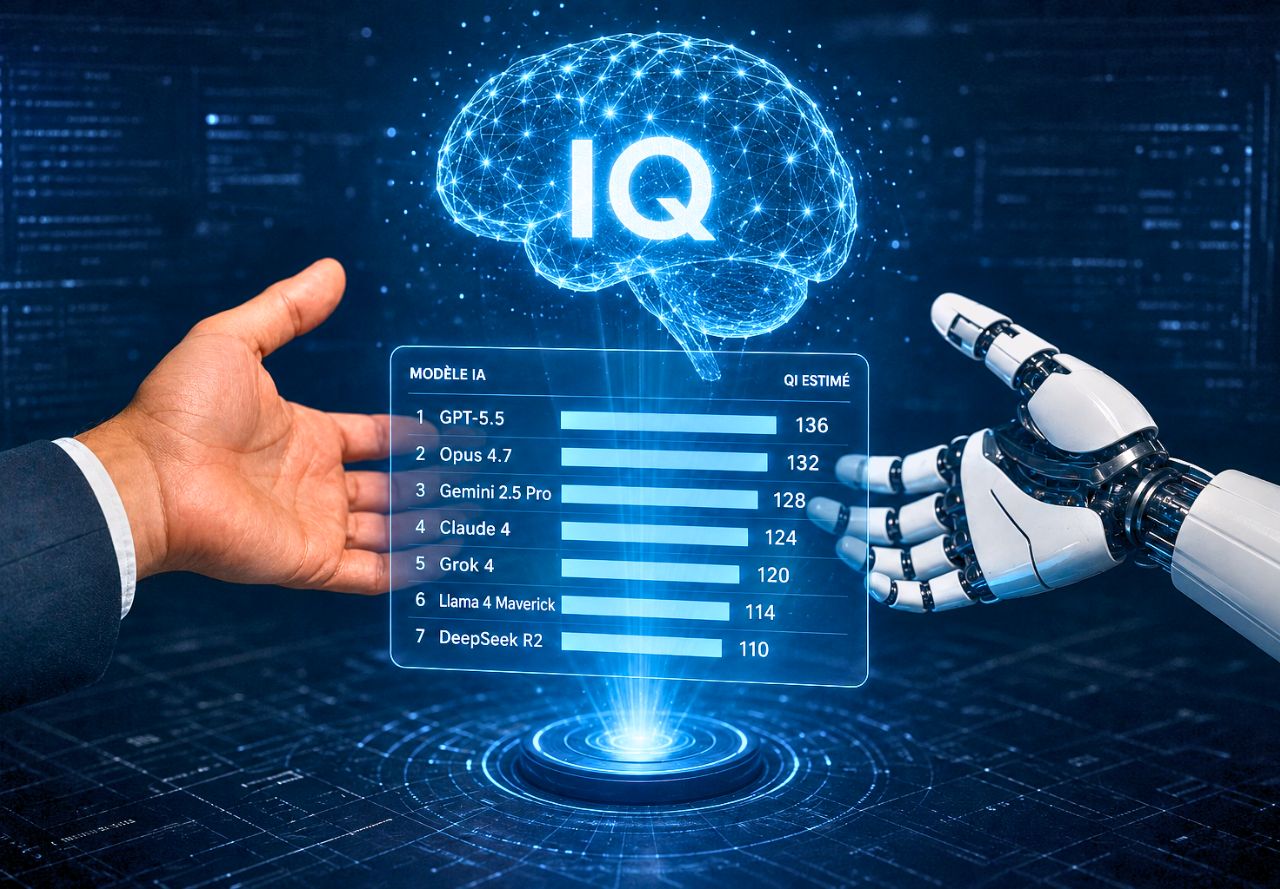
Quatre nombres, quatre logos, une hiérarchie qui se partage en une capture d’écran. Le succès de ce type de classement tient entièrement à sa lisibilité. Ce qu’il agrège est nettement plus fragile que le chiffre unique qu’il affiche, et deux classements construits sur des mesures différentes placent parfois les mêmes modèles dans un ordre inverse.
Ce que dit le classement
Les valeurs publiées en mai 2026 par le site agrégateur à l’origine de ce palmarès sont les suivantes.
- GPT-5.5, développé par OpenAI, en tête avec un score estimé à 136.
- Opus 4.7, développé par Anthropic, à 132.
- Gemini 3.1 Pro, développé par Google, à 131.
- GPT-5.4 également à 131, à égalité avec le précédent.
- Grok-4.20 Expert, développé par xAI, à 130.
- Sur une échelle différente, inspirée d’un test proposé par une association norvégienne, deux modèles atteignent 145.
Le vocabulaire employé mérite d’être noté : le site parle de score estimé, pas de quotient intellectuel mesuré. Cette nuance figure dans la présentation originale et disparaît systématiquement dans les reprises, où le chiffre devient une caractéristique du modèle plutôt que le résultat d’une conversion.
Un premier constat s’impose à la lecture de ces nombres : l’écart entre le premier et le cinquième est de six points. Sur une échelle où l’écart-type vaut quinze points, cela signifie que ces modèles se situent dans un mouchoir de poche. La hiérarchie affichée est donc beaucoup moins tranchée que sa présentation ne le suggère.
La coexistence de deux échelles donnant 136 et 145 pour des modèles comparables signale déjà que le chiffre dépend davantage de la méthode de conversion que du modèle mesuré.
Comment il est construit
Comprendre la fabrication de ce score permet d’en situer la portée, et le procédé n’a rien de mystérieux.
Le site agrège une douzaine de tests publics existants, dont plusieurs sont bien identifiés dans le domaine : un test de raisonnement abstrait, un test de questions scientifiques de niveau doctoral, un test de mathématiques avancées. Les résultats sont répartis en cinq dimensions : abstraction, raisonnement mathématique, programmation, raisonnement critique et raisonnement agentique.
Une note supplémentaire d’intelligence émotionnelle est dérivée d’un test dédié. Cette addition élargit encore le champ, alors que la notion même d’intelligence émotionnelle appliquée à un modèle reste contestée dans la communauté qui travaille sur l’évaluation.
L’étape décisive est la conversion. Passer d’un ensemble de pourcentages de réussite à un nombre unique exprimé sur une échelle de quotient intellectuel suppose des choix de pondération et d’étalonnage. Ce sont ces choix qui déterminent le classement final, et ils relèvent de décisions de conception plutôt que de mesures.
Pourquoi le QI ne se transpose pas
L’objection la plus solide ne porte pas sur la qualité des tests agrégés mais sur l’unité employée pour restituer le résultat.
Le quotient intellectuel n’est pas une quantité absolue. C’est une échelle relative, construite en positionnant un individu par rapport à une population de référence, avec une moyenne fixée à cent et un écart-type de quinze. Dire qu’une personne a un score de 130 revient à dire qu’elle se situe au-dessus d’environ quatre-vingt-dix-huit pour cent de la population testée. Le nombre n’a de sens que par rapport à ce groupe.
Appliquer cette échelle à un modèle informatique pose donc un problème immédiat : quelle population de référence ? Le modèle n’appartient pas au groupe qui a servi à étalonner l’échelle, et il n’existe pas de population de modèles normalement distribuée permettant de refaire l’opération.
Un exemple rend cette difficulté concrète. Si l’on construisait une échelle en prenant comme population de référence les modèles disponibles aujourd’hui, le meilleur d’entre eux obtiendrait mécaniquement un score élevé et le moins performant un score faible, quelles que soient leurs capacités absolues. L’échelle se déplacerait à chaque nouvelle sortie. C’est précisément ce que la normalisation humaine évite, en fixant une population de référence stable.
Une seconde objection touche au fondement même de la mesure. Le quotient intellectuel repose sur une corrélation observée chez l’humain entre des performances cognitives très différentes : quelqu’un de fort en raisonnement verbal l’est généralement aussi en raisonnement spatial. Rien n’établit que cette corrélation existe pour les modèles. Un système peut résoudre des problèmes mathématiques de niveau recherche et échouer sur une tâche triviale, profil qu’aucun test humain ne produit.
Le problème de la contamination
La littérature académique consacrée à l’évaluation des modèles identifie plusieurs difficultés structurelles, dont une particulièrement gênante pour ce type de classement.
- La contamination des données : les questions d’un test public circulent en ligne et peuvent figurer dans les données ayant servi à entraîner le modèle.
- La saturation : un test finit par être réussi par tous les modèles récents, ce qui le rend incapable de les départager.
- L’obsolescence rapide des contenus, un test conçu il y a deux ans ne mesurant plus les capacités qui comptent aujourd’hui.
- L’opacité des choix de conception : définition des capacités mesurées, sélection des contenus, choix des métriques, rarement justifiés formellement.
- La redondance entre tests différents mesurant en réalité la même chose.
Ces limites ne sont pas des critiques marginales adressées de l’extérieur : elles émanent de la communauté de recherche qui conçoit ces évaluations. Les chercheurs relèvent notamment que les choix de conception les plus déterminants, comme la définition de ce qu’on entend mesurer, sont rarement justifiés de manière formelle. Cette opacité empêche de vérifier qu’un test mesure réellement ce qu’il annonce.
La contamination mérite qu’on s’y arrête, car elle vide le résultat de sa signification. Si les questions d’un test ont été vues pendant l’entraînement, le modèle ne raisonne pas : il restitue. Le score obtenu ne mesure alors plus une capacité mais une mémorisation, et rien ne permet de distinguer les deux depuis l’extérieur. Les chercheurs qui travaillent sur ces questions relèvent que ce phénomène rend certains scores non informatifs, voire trompeurs pour décider d’un déploiement.
C’est pourquoi les équipes d’évaluation sérieuses conservent des jeux de questions privés, jamais publiés. Un test dont les réponses sont publiques perd sa valeur discriminante dès la génération de modèles suivante.
Quand les classements se contredisent
La démonstration la plus convaincante des limites d’un score unique vient de travaux comparant plusieurs méthodes d’évaluation sur les mêmes modèles.
Des chercheurs ont mesuré la qualité du travail réellement accompli par des modèles sur des tâches de programmation longues en environnement professionnel, puis comparé leur classement à celui obtenu sur les tests académiques agrégés. Les écarts sont importants et systématiques.
Certains modèles très bien placés sur les tests académiques reculent nettement sur le travail réel de longue durée. D’autres font l’inverse : ils traitent mieux les tâches complexes étalées dans le temps que leur classement académique ne le laisse supposer. Le résultat le plus frappant concerne les corrélations entre tests, dont certaines sont carrément négatives : mieux réussir l’un s’accompagne de moins bien réussir l’autre.
Ces divergences ne signalent pas qu’un classement aurait tort et l’autre raison. Elles indiquent que les tâches mesurées sont réellement différentes. Répondre à une question scientifique isolée et mener à bien une tâche complexe sur plusieurs heures mobilisent des qualités distinctes : la première demande de la connaissance et du raisonnement, la seconde de la persévérance, de la mémoire du contexte et une capacité à se corriger.
La conclusion s’impose d’elle-même. Il n’existe pas un axe unique de performance dont un chiffre pourrait rendre compte. Selon la tâche visée, le meilleur modèle n’est pas le même, et un classement général masque précisément l’information dont un utilisateur a besoin.
Ce qui reste utile malgré tout
Écarter entièrement ces classements serait excessif. Ils remplissent une fonction réelle, à condition de savoir laquelle.
Leur premier apport est de rendre lisible un domaine devenu illisible. Comparer des modèles sur douze tests aux noms obscurs dépasse largement ce qu’un lecteur non spécialiste peut faire. Un chiffre unique, même imparfait, permet de suivre une tendance générale.
Leur second apport tient au suivi dans le temps. Même si le niveau absolu ne signifie rien, l’écart entre deux générations d’un même modèle mesuré avec la même méthode dit quelque chose de la progression. C’est une lecture relative, et elle est défendable tant que la méthode ne change pas.
Le troisième apport est de signaler un resserrement. En mai 2026, six points séparent le premier du cinquième, alors que les écarts étaient beaucoup plus marqués auparavant. Cette convergence est une information en soi : les principaux modèles se rapprochent en capacités générales, ce qui déplace le critère de choix vers d’autres considérations, comme nous le développions dans notre comparatif entre Gemini et ChatGPT.
Comment choisir pour son entreprise
Pour une TPE ou une PME qui doit sélectionner un outil, ces classements sont à peu près inutiles. Les critères qui comptent sont ailleurs.
- Tester sur vos propres tâches, avec vos propres textes et vos propres cas. Une demi-journée d’essai comparatif vaut tous les classements.
- Vérifier l’intégration avec les outils que vous utilisez déjà, souvent plus déterminante que la qualité brute du modèle.
- Examiner le traitement des données saisies, question qui ne figure dans aucun benchmark.
- Considérer le coût réel à l’usage, sur la base de votre volume, plutôt que le tarif affiché.
- Regarder la stabilité de la disponibilité et les limites d’usage, sujet traité dans notre article sur les restrictions imposées à des utilisateurs payants.
- Ne pas changer d’outil à chaque classement, le coût d’apprentissage dépassant généralement le gain marginal.
Le quatrième point mérite une précision. Un modèle plus performant consomme généralement davantage de ressources, donc coûte plus cher à l’usage. Pour une tâche simple et répétitive, un modèle intermédiaire produit un résultat équivalent pour une fraction du prix. Choisir systématiquement le mieux classé revient souvent à surpayer une capacité dont on n’a pas l’emploi.
Le premier point est de loin le plus rentable. Un modèle classé troisième peut se révéler meilleur que le premier sur votre usage précis, parce que votre usage n’est pas celui que les tests mesurent. Rédiger des devis dans un français correct, résumer des échanges avec un client ou traiter un fichier comptable ne figurent dans aucun test de raisonnement abstrait. L’intégration dans les outils existants pèse d’ailleurs de plus en plus, comme le montrent les évolutions décrites dans nos articles sur l’intégration de plusieurs modèles dans un outil de création et sur l’arrivée d’un assistant au cœur d’un système mobile.
Les usages concrets se multiplient bien au-delà de la conversation, comme le montre notre article sur la transformation de documents personnels en contenus audio. Aucun de ces usages n’est mesuré par un test de quotient intellectuel.
Ce qu’on nous demande le plus souvent.
Quel modèle a le QI le plus élevé ?
Selon le site agrégateur, GPT-5.5 arrivait en tête en mai 2026 avec 136, devant Opus 4.7 à 132, puis Gemini 3.1 Pro et GPT-5.4 à 131. Une autre échelle attribue 145 à deux modèles, ce qui montre à quel point le chiffre dépend de la méthode de conversion.
Ces scores sont-ils fiables ?
Ils reposent sur des tests réels, mais leur conversion en score de quotient intellectuel relève de choix de conception. Cette échelle est conçue pour situer un humain dans une population humaine, ce qui n’a pas d’équivalent pour un modèle informatique.
Qu’est-ce que la contamination des données ?
Le fait que les questions d’un test public aient pu figurer dans les données d’entraînement du modèle. Dans ce cas, le score mesure une mémorisation plutôt qu’une capacité de raisonnement, sans qu’il soit possible de distinguer les deux depuis l’extérieur.
Peut-on comparer une IA à un humain avec ces chiffres ?
Non. Le quotient intellectuel humain repose sur une corrélation entre performances cognitives différentes, corrélation dont rien n’établit qu’elle existe pour les modèles. Un système peut résoudre un problème de recherche et échouer sur une tâche triviale, profil qu’aucun test humain ne produit.
Pourquoi les classements se contredisent-ils ?
Parce qu’ils mesurent des choses différentes. Des travaux comparant les tests académiques au travail réel de programmation montrent des écarts importants, avec certaines corrélations négatives. Il n’existe pas d’axe unique de performance dont un chiffre rendrait compte.
Comment choisir un outil pour mon entreprise ?
En testant sur vos propres tâches plutôt qu’en suivant un classement. Une demi-journée d’essai comparatif avec vos textes et vos cas réels renseigne davantage que n’importe quel palmarès général, car votre usage n’est pas celui que les tests mesurent.
- Scores publiés en mai 2026 par le site agrégateur convertissant douze tests publics en score estimé, réparti sur cinq dimensions.
- Échelle parallèle inspirée d’un test proposé par une association norvégienne, aboutissant à des valeurs différentes pour des modèles comparables.
- Travaux académiques sur les limites des évaluations de modèles : contamination des données, saturation, obsolescence des contenus et opacité des choix de conception.
- Étude comparant les classements obtenus sur des tests académiques agrégés et sur des tâches de programmation longues en environnement réel, relevant des corrélations divergentes voire négatives.
- Documentation méthodologique sur la construction des échelles de quotient intellectuel et leur normalisation sur une population de référence.
WY-Créations conçoit des sites internet et construit des stratégies de visibilité pour les artisans, les TPE, les PME et les professions libérales depuis 2018. Les scores publiés sont rapportés avec leur méthode de construction et ses limites ; aucun classement n’est présenté comme une mesure objective de capacité. Pour aller plus loin : les avis clients, à propos de l’agence ou nous écrire.
Avez-vous testé ces outils sur vos propres dossiers ?
Rédiger un devis, résumer un échange client, traiter un fichier comptable : aucun de ces usages ne figure dans un test de raisonnement abstrait. Une demi-journée d’essai comparatif vaut tous les classements.